9초 걸리던 PDF, 화면 캡처를 걷어냈다
9초 걸리던 PDF, 화면 캡처를 걷어냈다
우리 회사에는 수검자 정보를 받아 검사 결과 리포트를 출력해주는 서비스가 있다. 입사하고 이 기능을 처음 확인했을 때 리포트 한 건을 만드는 데 최대 9초 이상 걸리고 있었고, 하루에 많게는 40번 넘게 리포트를 뽑는 검사자들에게서 "출력이 왜 이렇게 느리냐"는 VOC가 자주 접수되고 있었다.
왜 "최적화"가 아니라 "구조 변경"이었나
처음에는 Python 서버 튜닝이나 이미지 압축 같은 방향을 떠올릴 수 있었다. 실제로 그 방향을 먼저 검토했다.
그런데 분석해 보니 병목이 한 곳에 있는 게 아니었다. 데이터 하나가 PDF가 되기까지 거치는 단계마다 비용이 붙었다. 화면을 이동할 때마다 렌더링을 기다리고, 그 화면을 스크린샷으로 찍고(CPU와 메모리), 이미지를 S3에 올리고, Python 서버가 그걸 다시 내려받고(네트워크 I/O가 화면 수만큼 왕복), 마지막에 이미지들을 PDF로 합친다. 화면이 10개면 S3 업로드와 다운로드가 각각 10번씩 발생한다. 이걸 "최적화"한다는 건 각 단계를 조금씩 줄이는 건데, 구조 자체가 비효율의 원인이면 그렇게 깎아봐야 한계가 뻔하다.
근본 문제는 화면 캡처 방식 그 자체였다.
뜯어보면 좀 황당한 구조였다. 리포트에 박혀야 할 데이터는 이미 우리 DB에 멀쩡히 정규화돼 있었다. 그런데 시스템은 그 데이터를 굳이 브라우저 화면에 렌더링한 뒤, headless 브라우저로 스크린샷을 찍어 이미지로 만들고, 그 이미지를 S3에 올렸다가 Python 서버가 다시 내려받아 PDF로 합치고 있었다. DB에 답이 다 있는데 화면을 한 바퀴 빙 돌아 이미지로 찍고 다시 합치는, 그 한 바퀴가 9초의 정체였다. 데이터는 이미 있는데 굳이 화면을 경유할 이유가 없었다.
그래서 뭘로 바꿀까
구조를 바꾸기로 하고 나니, 이번엔 어떤 방식으로 비동기를 만들지가 문제였다.
제일 먼저 떠오른 건 그냥 백그라운드 스레드로 처리하는 거였다. 요청 받으면 스레드 하나 띄워서 처리하고 응답만 먼저 주는 식. 그런데 서버가 재시작되거나 죽으면 처리 중이던 리포트가 그대로 증발한다. 의료 플랫폼에서 리포트 유실은 그냥 넘어갈 문제가 아니다. 동시 요청이 몰리면 스레드가 폭발하는 것도 걸렸다.
배치 스케줄러도 생각해봤다. 주기적으로 미처리 리포트를 모아 한 번에 생성하는 방식. 안정적이긴 한데, 요청하고 다음 배치 주기까지 기다려야 한다. "생성 누르면 곧 나와야 한다"는 현장 요구랑 정면으로 부딪혔다.
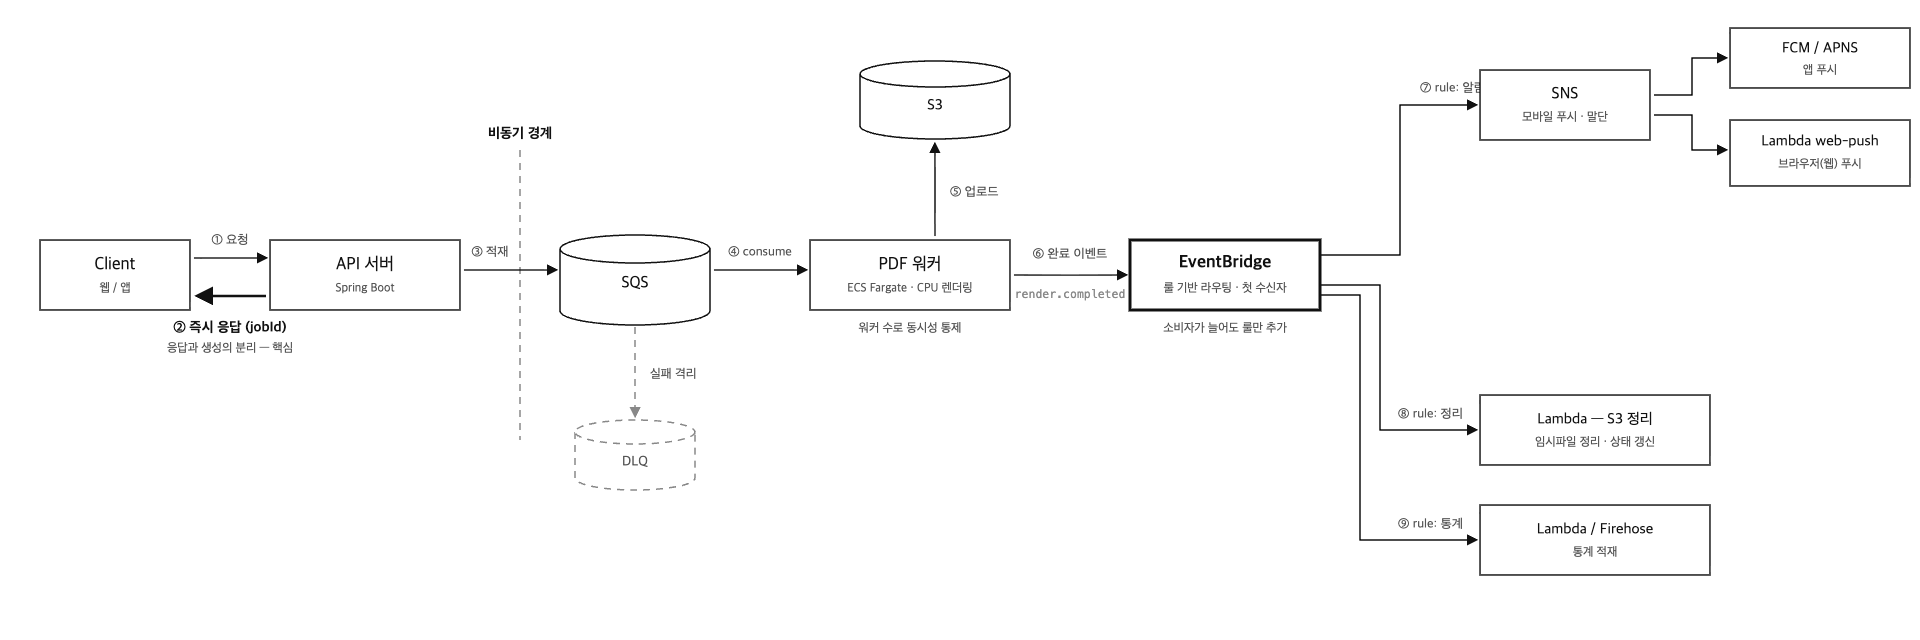
결국 남은 게 메시지 큐 + 워커였다. 요청을 큐에 넣어두면 서버가 재시작돼도 메시지는 큐에 남아 있고(내구성), 워커 수를 조절해 처리량도 맞출 수 있고(확장성), 요청자는 큐에 넣자마자 응답을 받는다(응답성). 내가 필요했던 세 가지를 동시에 만족하는 건 이 방식뿐이었다.
큐는 SQS로
MQ 중에서는 SQS를 골랐다. 서버가 재시작돼도 메시지가 큐에 살아 있고, 요청하면 바로 응답이 나가야 한다는 게 가장 큰 포인트였다. 요청을 받는 쪽은 워커가 하나라 꺼내 쓰면 돼서, Kafka처럼 한 이벤트를 여러 컨슈머가 나눠 받는 구조까지는 필요 없었다.
바꾼 구조
앞의 그림 아래쪽이 바뀐 구조다. 핵심은 두 가지다.
- 리포트 생성 요청과 리포트 조회를 완전히 분리했다. 사용자는 요청 즉시 응답을 받고, 나중에 리포트 조회 버튼을 누르면 S3에서 완성본을 바로 받는다.
- 화면 캡처를 제거하고 DB 데이터를 직접 읽어 PDF를 만들었다.
완료 알림은 EventBridge + SNS로
생성이 비동기가 되면서, 리포트가 완성됐다는 걸 알려줄 방법이 필요했다. 모바일 앱 푸시 알림이 필요해서 SNS를 썼고, S3에 PDF가 올라온 걸 감지해야 해서 EventBridge로 그 이벤트를 받아 SNS로 연결했다. 알림은 의료진이 쓰는 서비스로만 나간다.
트레이드오프: 즉시 응답 vs 폴링
이 구조의 트레이드오프는 명확하다. 사용자가 "리포트 생성" 버튼을 누른 직후에는 PDF가 없다. 워커가 처리를 끝낸 뒤에야 다운로드할 수 있다.
이걸 처리하는 방법으로 두 가지를 검토했다.
방법 A: 폴링 (Polling). 클라이언트가 주기적으로 "리포트 준비됐어?" API를 호출하는 방식이다. 구현은 단순하지만 불필요한 요청이 반복된다.
방법 B: 상태 기반 조회. "리포트 조회" 버튼을 누를 때 S3에 파일이 있으면 다운로드, 없으면 "생성 중" 메시지를 보여주는 방식이다.
플랫폼 사용 패턴을 보니 리포트 생성 후 바로 다운로드하는 게 아니라 검사 마무리 상담을 한 뒤 다운로드하는 경우가 많았다. 그 사이에 워커가 처리를 끝낸다. 폴링 없이 상태 기반 조회만으로 충분했다. 폴링을 따로 두지 않은 대신, 리포트가 완성됐다는 사실 자체는 앞의 SNS 알림으로 의료진에게 전달됐다.
결과
가장 크게 바뀐 건 사용자가 기다리지 않게 됐다는 점이다. 전엔 생성 버튼을 누르면 9초 넘게 화면이 멈춰 있었는데, 이제는 누르는 즉시 다음으로 넘어간다. 생성은 백그라운드 워커가 맡고, PDF 자체도 화면 캡처를 걷어낸 덕에 9초에서 1.5초로 줄었다(83% 단축).
의료진 입장에선 생성 버튼을 누르면 바로 다음 화면으로 넘어가고, 환자와 상담을 마친 뒤 다운로드를 누르면 리포트가 그 자리에서 나온다. 피크 타임에도 버티고, 반복되던 "출력이 왜 이렇게 느리냐"는 VOC도 거의 끊겼다.